なぜ今このアーキテクチャを読むべきか
MLシステムを運用していると、必ずぶつかるジレンマがあります。「計算効率」と「デプロイ速度」は一般にトレードオフの関係に見えます。計算を共有するには複数のフィーチャーを一つにまとめる必要があり、一つにまとめれば一つの失敗が全体のデプロイを止めてしまいます。
Metaも同じ壁に直面しました。広告ランキングモデルは1リクエストあたり2万件を超えるフィーチャーを必要としますが、初期のF3はすべてのフィーチャーを単一のマージグラフにコンパイルしてリリースしていました。効率は良好でしたが、フィーチャーDに誤りが一つあるだけでフィーチャーA、B、Cまで出荷が止まる構造でした。
本記事は、Metaがこの問題をどのようにリリース単位と実行単位を分離して解決したのか、その内部最適化4段階を読み解くインサイト記事です。大規模なフィーチャーストアやフィーチャーサービングレイヤーを設計する方にとって、直接的な参考になるはずです。
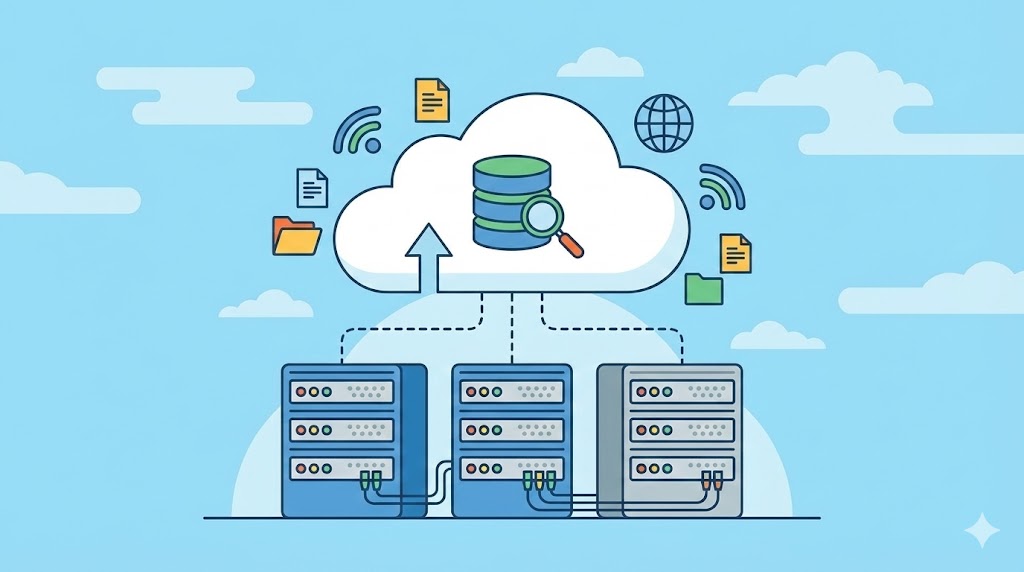
核心となるアイデア:「マージは捨て、共有は取り戻す」
F3 Lightningの目標は明確です。フィーチャーを個別に独立してデプロイしつつ、実行時には従来のマージグラフと同等の効率を維持する。 このために導入された4段階の最適化をコード視点で整理します。
Step 1. 安定した識別子(Stable Identifier)
独立コンパイルされたフィーチャー同士が同じ演算を共有しているか判定するには、ノード番号ではなく**「演算の意味」ベースの識別子**が必要です。Metaは(オペレーション, パラメータ, 入力識別子群)をハッシュして識別子を生成しました。入力順序が結果に影響しない場合はソートしてからハッシュします。
# 概念例:内容ベースの識別子生成
import hashlib

def compute_stable_id(op: str, params: dict, input_ids: list[str]) -> str:
    # 入力順序が結果に影響しない場合はソート
    normalized_inputs = sorted(input_ids)
    payload = f"{op}|{sorted(params.items())}|{normalized_inputs}"
    return hashlib.sha256(payload.encode()).hexdigest()

# 7日クリック数と7日インプレッション数が同じフィルタノードを共有する場合
# 同一の識別子が生成され、実行時には一度だけ実行される
filter_id = compute_stable_id("time_window_filter", {"window": "7d"}, ["event_source_click"])
重要なのは、数週間の間隔を空けてコンパイルされたフィーチャーでも、同じ演算なら同じIDを受け取るという点です。これが以降のすべての共有最適化の前提となります。
Step 2. 単一の実行計画(Execution Plan)
サービス起動時にすべてのアクティブフィーチャーを集め、トポロジカルソートした後、同一識別子のノードは一つだけ残し、すべてのコンシューマをそのノードに接続します。毎リクエストでグラフを走査しないよう、平坦化されたリストに変換するのもポイントです。
# 概念例:トポロジカルソート + 重複ノード除去
def build_execution_plan(features: list[FeatureGraph]) -> list[Node]:
    merged: dict[str, Node] = {}
    for fg in features:
        for node in fg.nodes:
            if node.id not in merged:
                merged[node.id] = node
            else:
                # 同一演算は既存ノードへコンシューマをリダイレクト
                fg.redirect(node.id, merged[node.id].id)
    # トポロジカルソート後、平坦化された実行順序を返す
    return topological_sort(list(merged.values()))
ここで注意すべき点は、ある演算が失敗した場合、下流ノードのみをnot-readyとしてマークし、他の独立ブランチは実行を継続させる必要があることです。この隔離がないと、共有がそのまま障害伝播になってしまいます。
Step 3. 共有メモリバッファ
Step 1と2で重複演算は消えたにもかかわらず、CPU使用率は依然として高いままでした。原因はメモリレイアウトでした。フィーチャーごとに自身のリクエストコンテナを保持していたため、中間結果があちこちに散在し、実行計画を辿るたびにキャッシュミスが頻発していました。
解決策はリクエストあたり一つのバッファです。起動時にすべてのフィーチャー参照をこのバッファのスロットに再バインドします。これにより三つの利点が生まれます。
- 局所性(locality): 連続する実行ステップが隣接メモリに触れるためキャッシュヒット率が向上
- 単一のreadinessベクトル: 値とは分離したベクトルで「準備済み」かだけを確認(空リストも有効な結果のため、値そのものでは判定不可)
- 重複コピーの排除: リスト/マップは参照のみ共有、スカラはコピー(ポインタ追跡よりコピーの方が安価)
# 概念例:リクエスト単位の共有バッファ
class RequestBuffer:
    def __init__(self, plan: list[Node]):
        self.slots = [None] * len(plan)
        self.ready = [False] * len(plan)  # 値と分離したreadinessベクトル

    def execute(self, plan: list[Node]) -> None:
        for idx, node in enumerate(plan):
            try:
                self.slots[idx] = node.compute(self.slots)
                self.ready[idx] = True
            except Exception:
                self.mark_downstream_not_ready(idx, plan)
Step 4. Dense Index Mapping
最後のボトルネックは識別子の参照コストでした。アクセスのたびにハッシュ → バケット探索 → ポインタ追跡が必要でした。Metaは起動時にすべての識別子に連続する整数スロットを割り当て、すべての参照をそのスロットへ書き換えました。結果としてリクエストパス上ではハッシュもルックアップテーブルもなく、配列インデックス一回で値を取り出せます。
これら4段階を経た結果、比較可能なフィーチャー基準で約3.6倍速いプロダクション反映とインフラ計算コストの増加なしを同時に達成したと報告されています。
注意点と批判的視点
このアーキテクチャをそのまま導入する前に確認すべき点があります。
1. 起動コストの影
「変わらない処理は起動時に行う」という原則は優れていますが、サービス起動時間が長くなるという副作用があります。フィーチャーが2万件規模であれば、トポロジカルソートと識別子の書き換えに相当な時間がかかり得ます。Metaはこれを許容できる規模でしたが、小規模チームではコールドスタート遅延の方が致命的になり得ます。
2. 識別子の安定性への強い依存
Step 1の内容ベース識別子は、**「同じ意味 = 同じハッシュ」**という仮定に全面的に依存します。パラメータ正規化ロジックにバグがある場合や、入力順序が実際には結果に影響するケースが存在する場合、静かに誤った共有が発生し得ます。識別子生成ロジックは別途強力なテスト対象であるべきです。
3. 単一バッファのメモリ圧迫
リクエストあたり一つのバッファは局所性の面で優れていますが、大規模なリスト/マップフィーチャーが多いモデルではリクエストあたりのメモリ使用量が増大します。Metaは「各バッファは1リクエストの間だけ保持される」という前提で安全性を確保しましたが、この前提が崩れる拡張(例:ストリーミングフィーチャー)では再検討が必要です。
4. 「共有失敗 = 下流のみ隔離」の落とし穴
共有ノードが失敗した場合、下流のみをnot-readyにすると述べられていますが、その共有ノードに依存するフィーチャーが20件あれば20件が同時に影響を受けます。隔離の単位は「個別フィーチャー」ではなく「依存グラフ単位」であることを明確に認識すべきです。
実務適用への提言
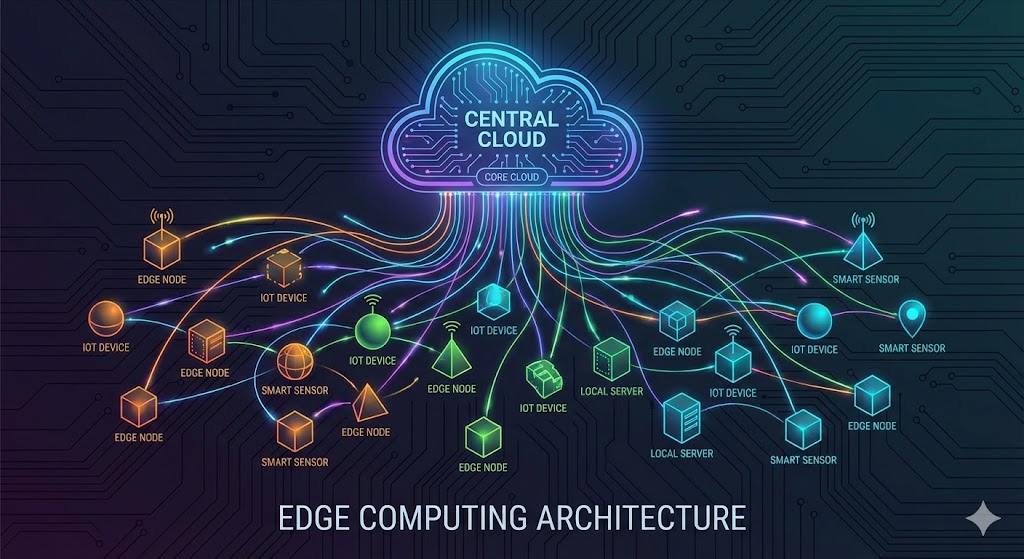
F3 Lightningの教訓は大規模システムに限定されません。フィーチャーストア、レコメンドシステム、さらにはマイクロサービスデプロイパイプラインにもそのまま適用可能な原則です。
三つに要約すると:
- デプロイ境界と実行境界を分離せよ。 一つのアーティファクトが「どう実行されるか」と「いつデプロイされるか」を同時に決定すると、そのアーティファクトは必ずボトルネックになります。
- リクエスト間で変わらない処理は起動時へ移せ。 共有作業の検出、実行順序の決定、結果の格納位置計算 — これら三つはリクエストごとに繰り返す理由がありません。
- 同じ演算を同じ順序で実行してもCPUコストは異なる。 結果がどこに格納され、いくつのコピーが存在するかは、演算回数と同じくらい重要です。これがこのプロジェクトで最も一般化可能な洞察です。
国内環境でもフィーチャーサービングレイヤーを直接運用している組織であれば、特に**「マージグラフを維持したままリリースだけを分離」しようとする誘惑に注意してください。Metaも当初はその方向で何度か改善を試みましたが、フィーチャーが増えるほど利得が侵食されたと述べています。根本的な解決は実行共有をマージから分離**することでした。
さらに深掘りしたい方は、ターミナルベースのAIコーディングツールの最新動向を扱ったGemini 3 FlashとGemini CLI活用ガイドも併せてご覧ください。また、リアルタイムインタラクティブAI生成モデルのアーキテクチャに興味があればWaypoint-1リアルタイム動画生成モデル分析を推奨します。
根拠資料: Meta Engineering - F3 Lightning: How Meta accelerates ads ML features to production